Исследование
Локальный LLM-агент
Путь от 1 до 16 токенов в секунду на RTX 3060. Корень оказался не там, где его искали.
OllamaopencodeCUDAPython
Симптом
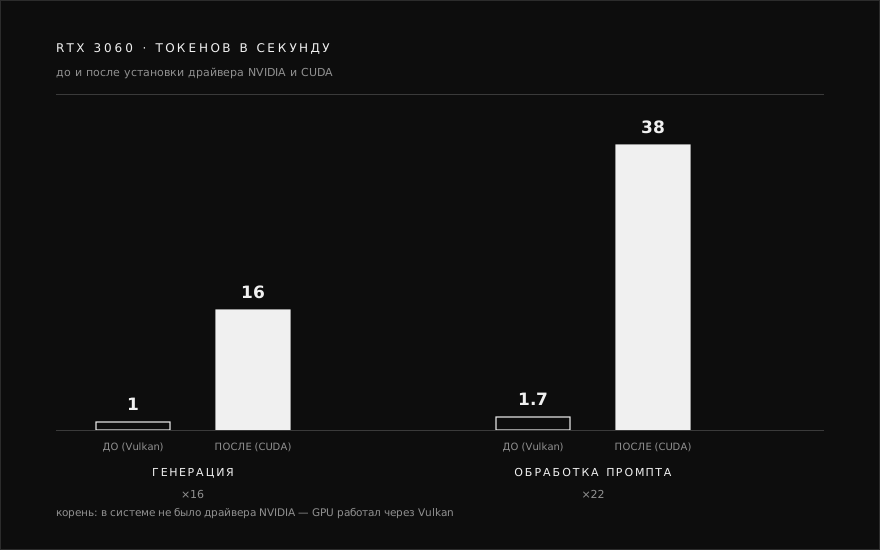
Локальная модель, поставленная агентом в opencode на ноутбуке с RTX 3060, выдавала 1 токен в секунду и падала по таймаутам.
Ложный след
Перебор квантов и режимов работы не дал ничего. Гипотеза о квантовании была дорогой в проверке и при этом неверной.
Настоящая причина
В системе не было драйвера NVIDIA — видеокарта считала через открытый Vulkan. После установки драйвера с CUDA и прокси, отключающего «думанье» модели, скорость выросла до 16 токенов в секунду, заработал вызов инструментов.
Что из этого следует
Ценность кейса не в цифрах. Дорогая гипотеза оказалась неверной, а дешёвая проверка окружения — верной. Проверять среду стоит первым делом.